我在nodeloc的帖子真的很多啊 - 互联网服务 / 杂谈 - NodeLoc中说到。完成后就开源项目和数据库
NodeLoc Public Archiver
GitHub工具开源(临时开发的Python 归档器。是属于能用就行的那种): GitHub - HEXUXIU/nodeloc-archiver: A conservative Python archiver for publicly accessible NodeLoc topics. It discovers topic URLs through the site's published sitemap and saves each topic's raw Discourse JSON plus checksummed metadata. · GitHub
Hugging Face数据存档:HEXUXIU2026/NodeLoc-Archiver · Datasets at Hugging Face
统计
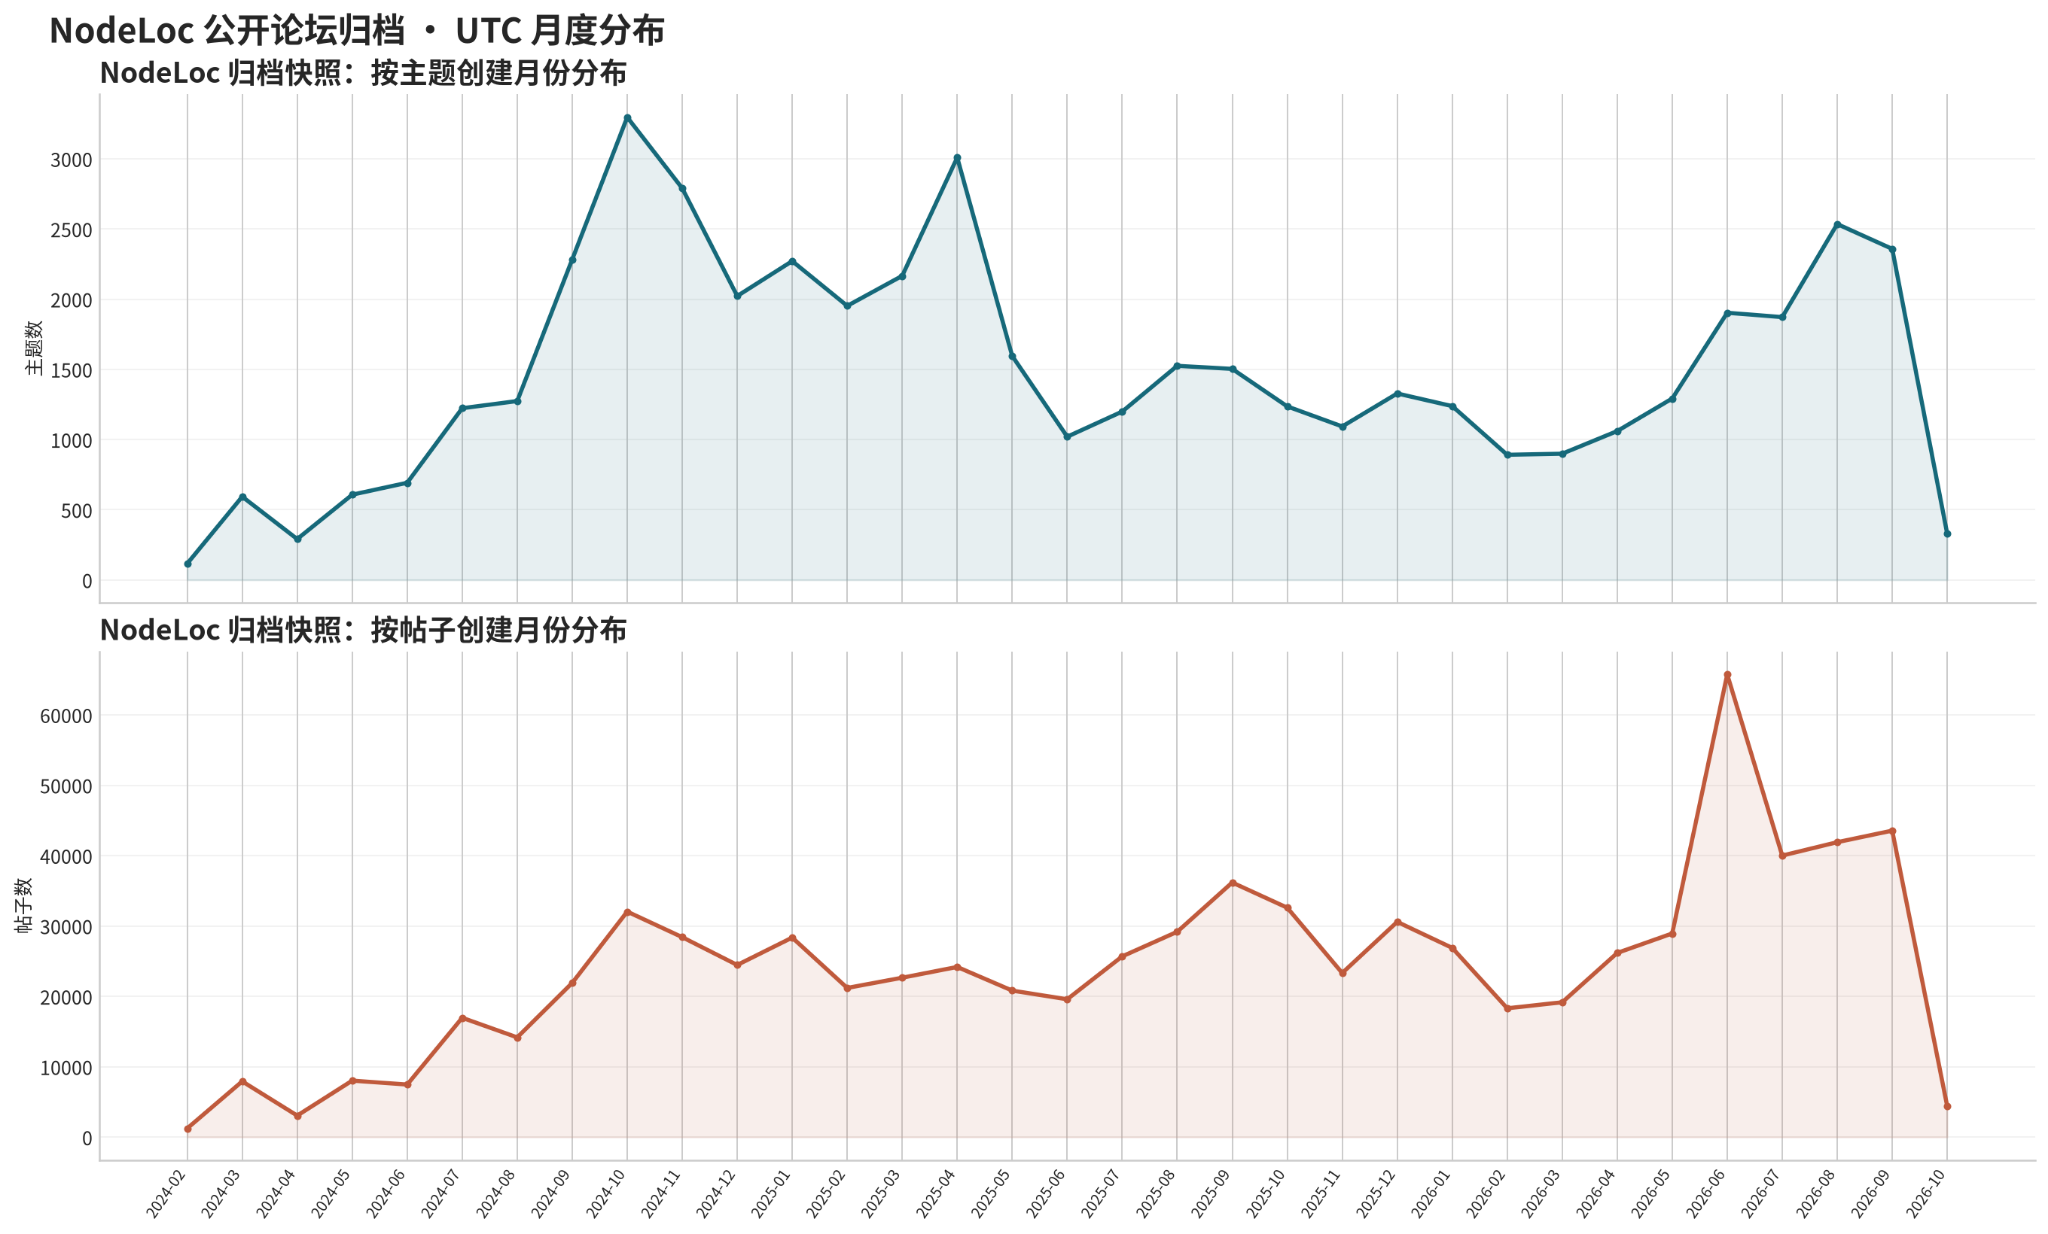
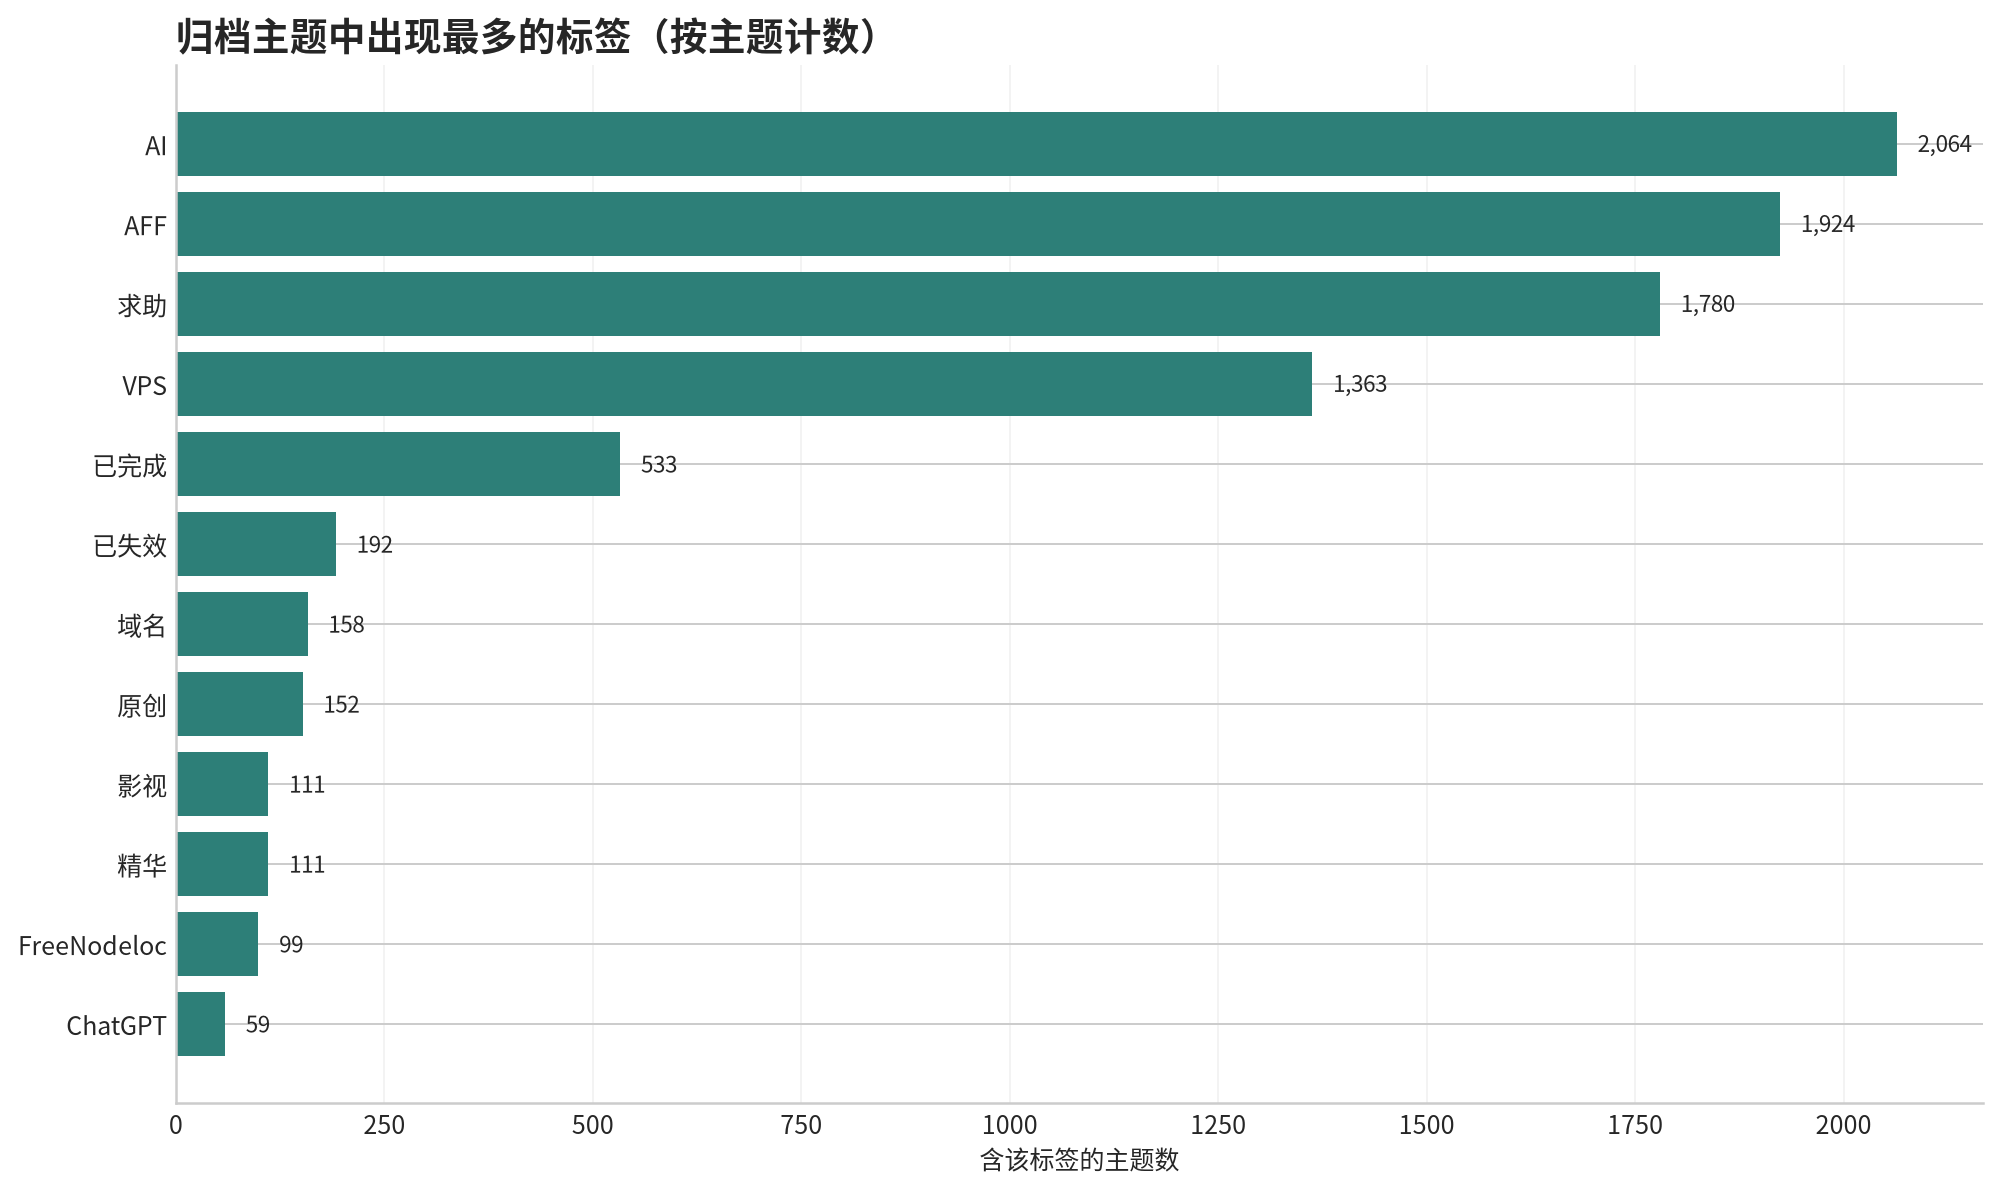
- 主题数:49460(站点 Sitemap 可发现的全部公开主题)
- 帖子数:795523
- 文件数:113561,约 2.54 GB
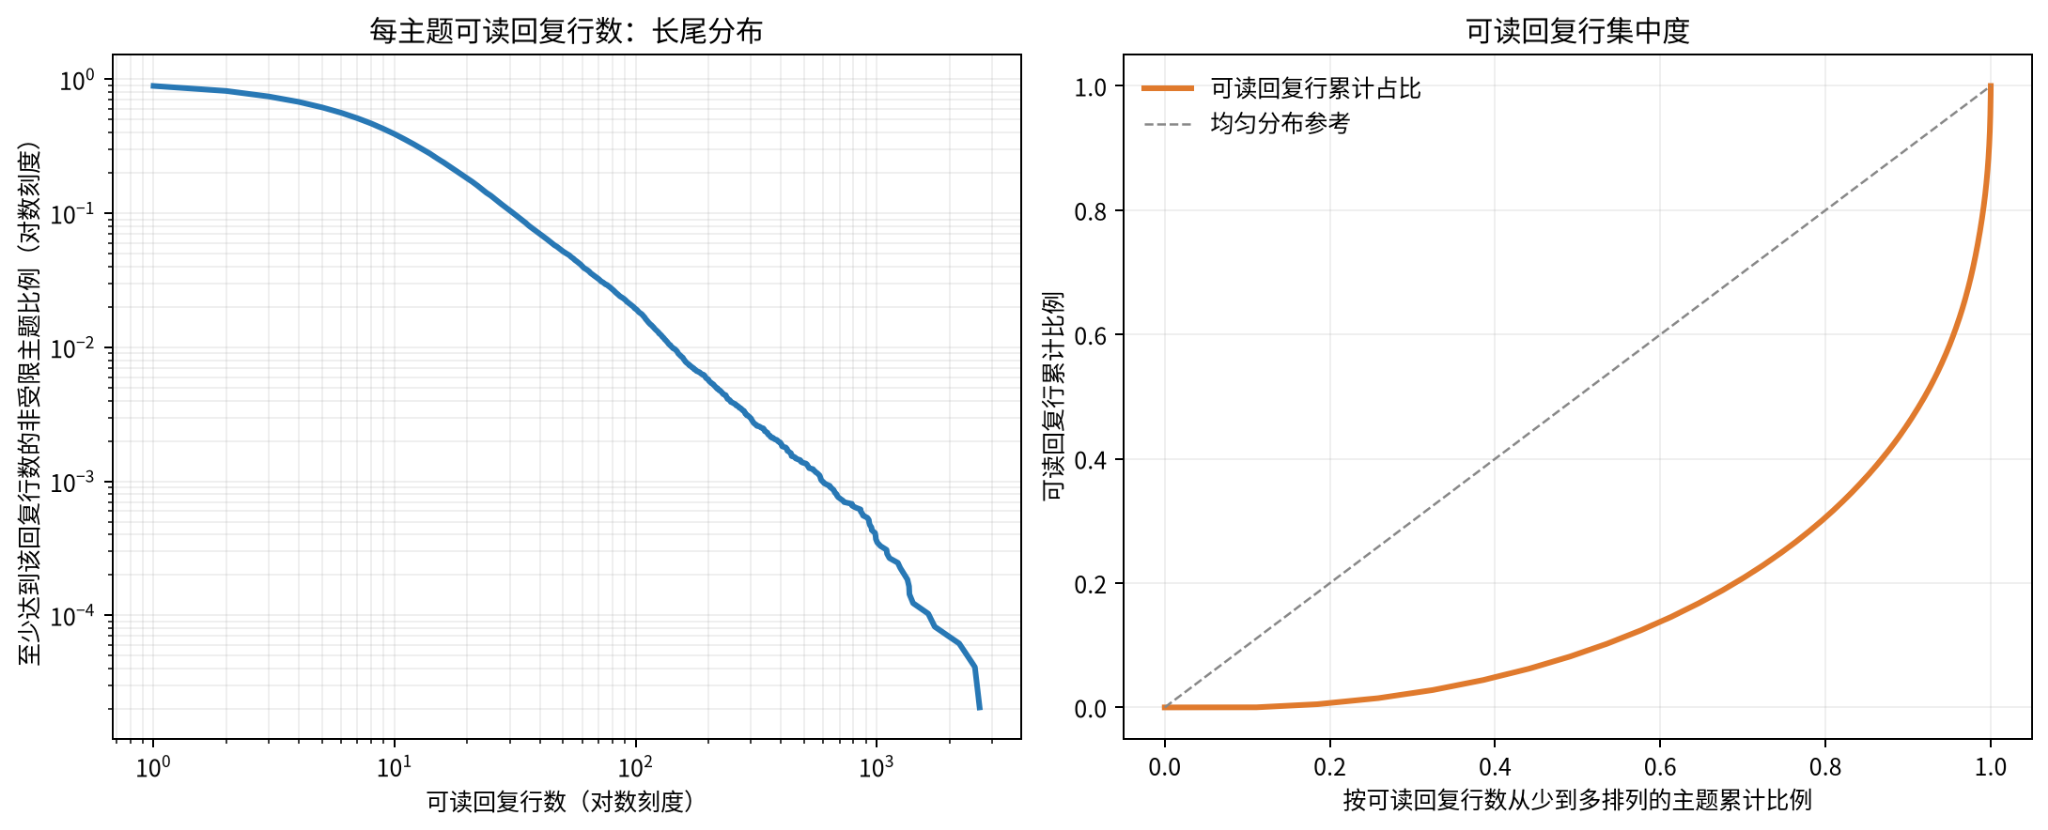
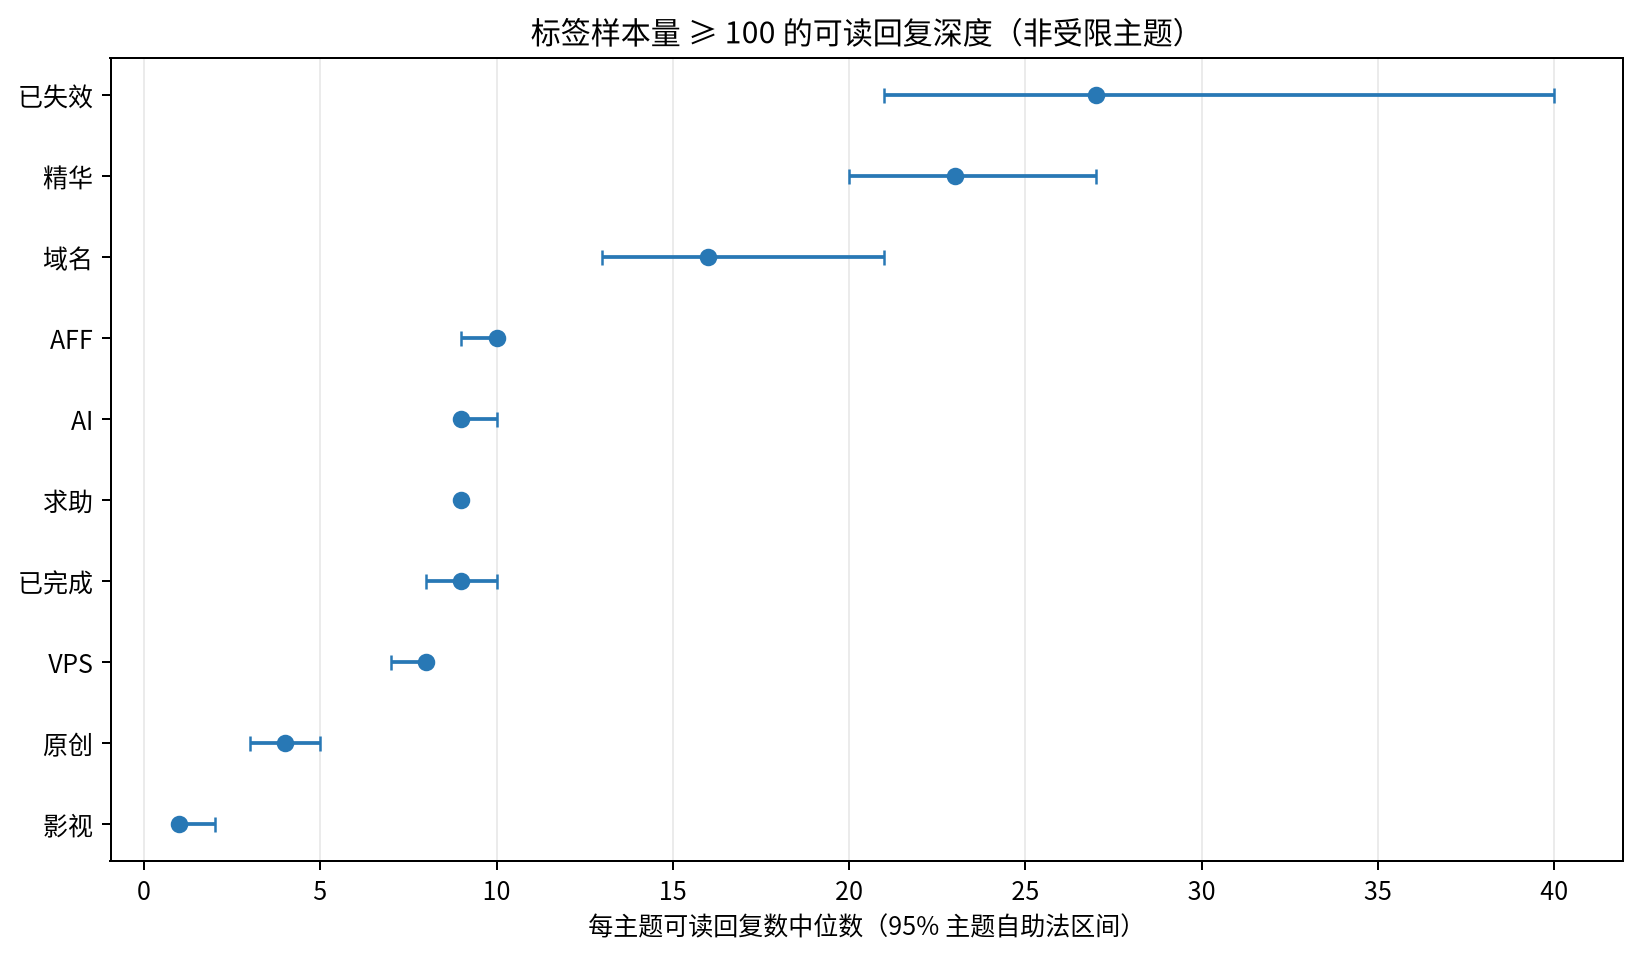
- 平均每主题 16.1 条帖子,中位数 8,最多 2672
- 权限受限主题:835,仅含站点返回的占位说明,无正文
站点页面显示的主题总数(约 11 万)包含已删除与私密主题。抽样 600 个未收录 ID 探测的结果是 595 个返回 404(已删除)、4 个仍公开、1 个权限受限,即实际缺口约 420 个。
=== repo tree ===
path MB
data/part0.bin 37.4
data/part1.bin 37.4
data/part2.bin 37.4
data/part3.bin 37.4
data/part4.bin 37.4
data/part5.bin 37.4
data/part6.bin 37.4
data/part7.bin 37.4
total MB: 299.5
数据分片说明
data/ 下的 part0.bin 到 part7.bin 是同一个归档包的 8 个连续字节分片。
还原方法
按顺序拼接后解压:
cat data/part0.bin data/part1.bin data/part2.bin data/part3.bin \
    data/part4.bin data/part5.bin data/part6.bin data/part7.bin \
    > topics.tar.gz

tar -xzf topics.tar.gz
Windows PowerShell:
$out = [IO.File]::Create("topics.tar.gz")
0..7 | ForEach-Object {
  $bytes = [IO.File]::ReadAllBytes("data/part$_.bin")
  $out.Write($bytes, 0, $bytes.Length)
}
$out.Close()
tar -xzf topics.tar.gz
校验
- 原始包:
data/topics.tar.gz,299,485,760 字节 - 分片数:8,每片 37,435,720 字节(最后一片为余数)
- 内容:
topics/目录,含 49460 个主题的原始 Discourse JSON 与 metadata
为什么不直接上传 11 万个文件
原始数据是 113561 个小文件(2.54 GB)。逐个上传需要 11 万次 HTTP 请求,在受限网络下极易中断。打包成单文件并分片,把请求数降到 8,总量因 JSON 文本高度可压缩而降到 0.29 GB。
•首帖/回复:48,616 / 746,458。
•主题时间:2024-02-26T17:31:05Z 至 2026-10-05T08:50:27.947000Z;
帖子时间:2024-02-26T17:31:05Z 至 2026-10-05T09:17:46.944000Z(UTC)