L
Chinese-tingfeng@lzA6#12026-10-05 01:412 赞 · 64 阅运行时稳定性(§4.2)
- 并发桶槽位泄漏(release × 队首超时无归属仲裁)→ 桶自我堵死全站 429:修归属仲裁
- 配置热更新与热路径读取 data race(可 fatal):改不可变快照 + 读主副本加锁
- EventBus.events 无界累积 → 有界 FIFO;live_request_tracker slice 残留
- gopool 容量上界(GOPOOL_MAX_WORKERS 默认 512)+ worker 可观测
出站压缩改进
- 压缩默认全渠道开启 + 失败熔断回退(上游拒绝 gzip 时本渠道临时禁用,到期自动恢复)
- 压缩级别可配(默认 6=Default,比 BestSpeed 压缩率更优)
- 压缩耗时统计(每条请求 + 累计)
- 默认阈值 256KB→50KB
实测诊断
首字慢 = 上游算力饱和(prefill + 背压),非出口带宽:单发 1MB 上传 0.44s、8 并发 0.5s;TCP 重传 0.14%;压缩率 57% 是内容熵极限(代码 0.3%、Base64 75%)
直接来看看效果图:
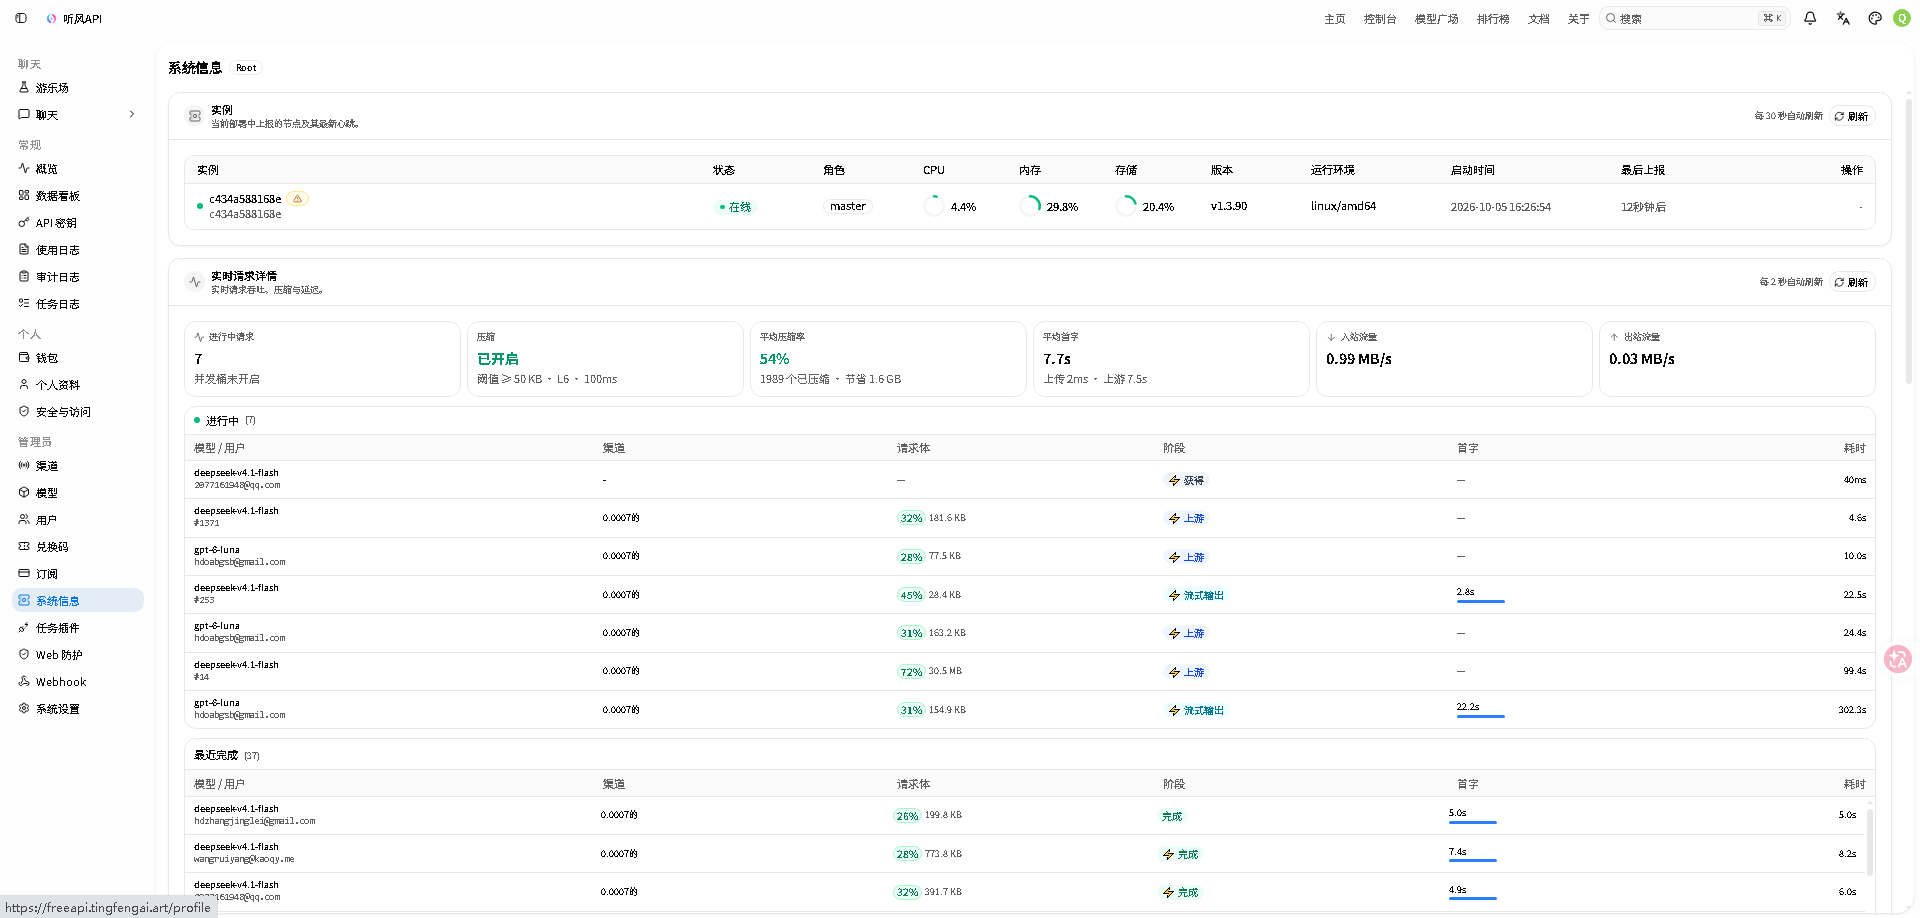
好像能减少带宽的同时也能充分利用CPU进行压缩