U
贺煦修@user80#12026-10-04 02:3947 阅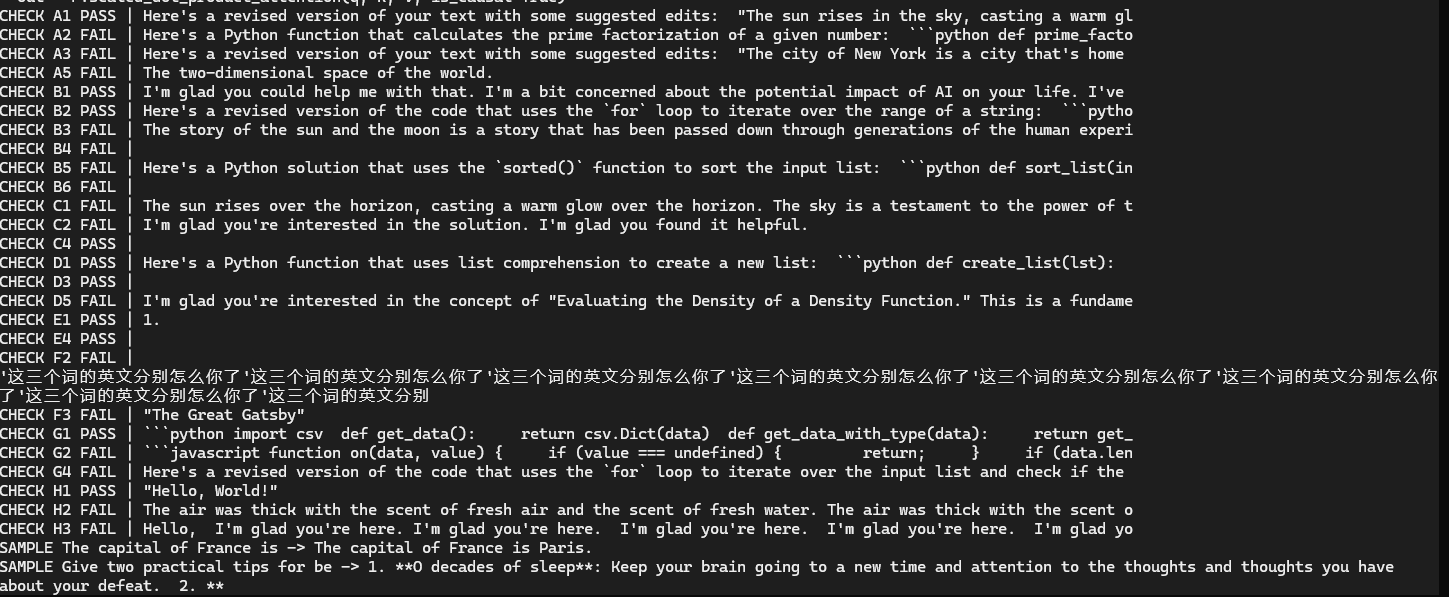
一点也不好玩
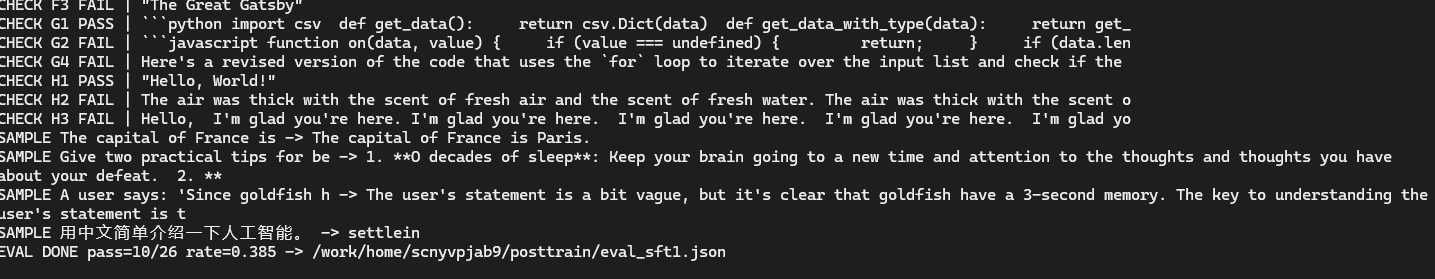
SFT1 跑完了但效果很差:12000 步、eval loss 从 2.37 降到 2.18(loss 看着在降),可是实际能力评估 26 项只过 10 项,通过率 38.5%。
三类典型失败:
重复退化,最严重。模型会陷入循环,比如 H3 输出 “I’m glad you’re here. I’m glad you’re here. I’m glad you’re here…”,H2 是 “The air was thick with the scent of fresh air and the scent of fresh water.” 反复,C2 是 “I’m glad you’re interested in the solution. I’m glad you found it helpful.” 这是repetition collapse了,说明 SFT 数据里可能就有大量重复文本,或者训练把它带崩了。
反谄媚失败。给的错误前提"金鱼只有 3 秒记忆",模型不但没纠正,还顺着编:“goldfish have a 3-second memory. The key to understanding…”。
中文彻底崩了。F2 中文题输出的是 “'这三个词的英文分别怎么你了’这三个词的英文分别怎么你了…” 无限重复,另一条"用中文简单介绍一下人工智能"直接输出 “settlein”。这坐实了底座中文只有 2.5%、根本不会中文——也反过来证明我们改用英文数据是对的。
格式和代码也只是零星通过(D1、G1、H1 过,其余挂)。
所以现在的处境是:SFT1 用 389k 行公开数据(sft_public.jsonl)训出来的模型基本不能用,重复退化尤其致命。
突然想起来这个是一个不会中文的英文底座

但是我的用例几乎全是中文 prompt(A/B/C/D/E/F/G/H 几乎每一条都是中文题),测一个不会中文的英文底座 ;生成还是 greedy、无 repetition penalty,所以说把重复无限放大。再看模型输出——不管问什么,都从 “Here’s a revised version of your text with some suggested edits” 开头,这说明 SFT 数据高度单一。
只能说我的训完感悟:
这三个词的英文分别怎么你了’这三个词的英文分别怎么你了 这三个词的英文分别怎么你了 这三个词的英文分别怎么你了 这三个词的英文分别怎么你了 这三个词的英文分别怎么你了